 YNSPIRA
Nei, AI-chatboten leser ikke alle dokumentene hver gang
Interne AI-chatboter som hjelper ansatte med å finne riktig informasjon har blitt ganske vanlige i mange organisasjoner. Et typisk eksempel er en HR-agent som svarer på spørsmål basert på personalhåndboken, eller en IT-agent som hjelper ansatte med å løse vanlige tekniske utfordringer.
Selv om slike agenter blir stadig vanligere, er det mange misforståelser om hvordan de søker i og plukker ut relevant informasjon.
Når du har lest denne artikkelen, vil du vite:
- hvordan denne typen AI-agenter (retrieval bots) søker i kunnskapskildene
- hvorfor de som regel ikke leser alle kunnskapskildene hver gang de svarer
- hva de gjør i stedet (spoiler alert: de bruker RAG, en metode vi kommer til å forklare med fokus på hva det betyr for deg som bruker)
- hvordan du bør skrive og strukturere interne dokumenter, slik at agenten finner riktig innhold
- hva du kan påvirke og hva som ligger utenfor din kontroll hvis du bygger en retrieval bot selv
Målet er å forklare de viktigste prinsippene for hvordan gjenfinning av informasjon fungerer i mange standard AI-agenter (spesielt retrieval bots) på en enkel og pedagogisk måte, ikke å gi en detaljert teknisk gjennomgang.
RAG-metoden som forklares i artikkelen, brukes av de fleste store AI-plattformer, inkludert Microsoft Copilot, ChatGPT, Claude og Gemini. Detaljene i hvordan den fungerer, varierer mellom plattformer og ulike oppsett, men de grunnleggende prinsippene er stort sett de samme.
Først: Hva er RAG?
RAG står for Retrieval-Augmented Generation og er en teknikk som gjør at AI kan søke etter relevant informasjon i tilgjengelige kunnskapskilder og bruke den til å svare på spørsmål. Den er særlig relevant når informasjonsgrunnlaget er stort, ikke når du bare gir AI en kort tekst eller noen få korte dokumenter.
Slik fungerer RAG i praksis
Først blir dokumentene gjennomgått og delt opp i mindre tekstbiter (ofte kalt chunks). Disse tekstbitene blir indeksert, slik at systemet senere kan søke i dem og finne relevant informasjon. Når du stiller et spørsmål, bruker agenten denne indeksen til å finne de mest relevante tekstbitene, istedenfor å lese hele kunnskapsbiblioteket.
Det er slik mange interne AI-chatboter fungerer, enten de er bygget i Microsoft Copilot Studio, ChatGPT, Claude eller andre AI-plattformer.
Et praktisk eksempel
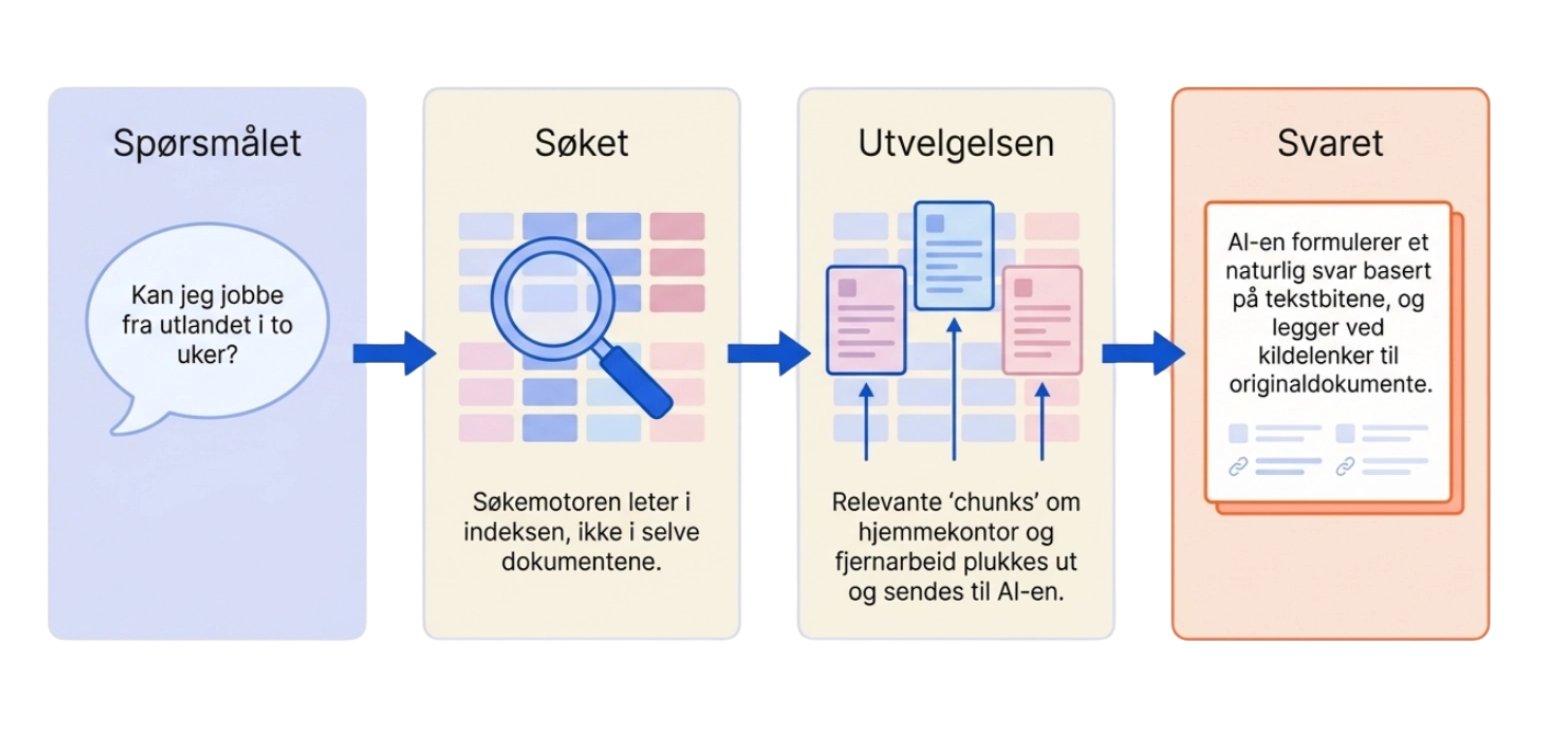
La oss ta et eksempel for å gjøre dette veldig konkret. Si at du spør HR-agenten: «Kan jeg jobbe fra utlandet i to uker?» Agenten søker i virksomhetens kunnskapskilder, finner relevante avsnitt om hjemmekontor og arbeid fra utlandet, og bruker denne informasjonen til å formulere et svar.
Men agenten leser ikke personalhåndboken fra start til slutt hver gang du stiller et spørsmål. Og den leser definitivt ikke hundrevis av filer den har tilgang til i kunnskapsbiblioteket sitt. I stedet bruker den RAG til å søke etter relevant informasjon i kunnskapskildene og bruke det den finner til å formulere et svar.
Dette skjer gjennom to prosesser:
- Indeksering, som gjør dokumentene søkbare
- Gjenfinning, som henter frem relevant informasjon når du stiller et spørsmål.
Indeksering, enkelt forklart
Se for deg at HR-agenten har 400 SharePoint dokumenter i kunnskapsbiblioteket sitt.
Hvis agenten skulle åpnet og lest samtlige dokumenter hver gang noen stilte et spørsmål, ville det vært både ekstremt tregt og ressurskrevende.
Derfor bruker RAG-systemer vanligvis en søkeindeks. En søkeindeks er litt som et avansert register over dokumentene. Den gjør det mulig å finne relevant informasjon uten å lese gjennom alt innholdet fra bunnen av hver gang.
Men hvordan kan systemet vite hva dokumentene inneholder uten å ha lest dem først?
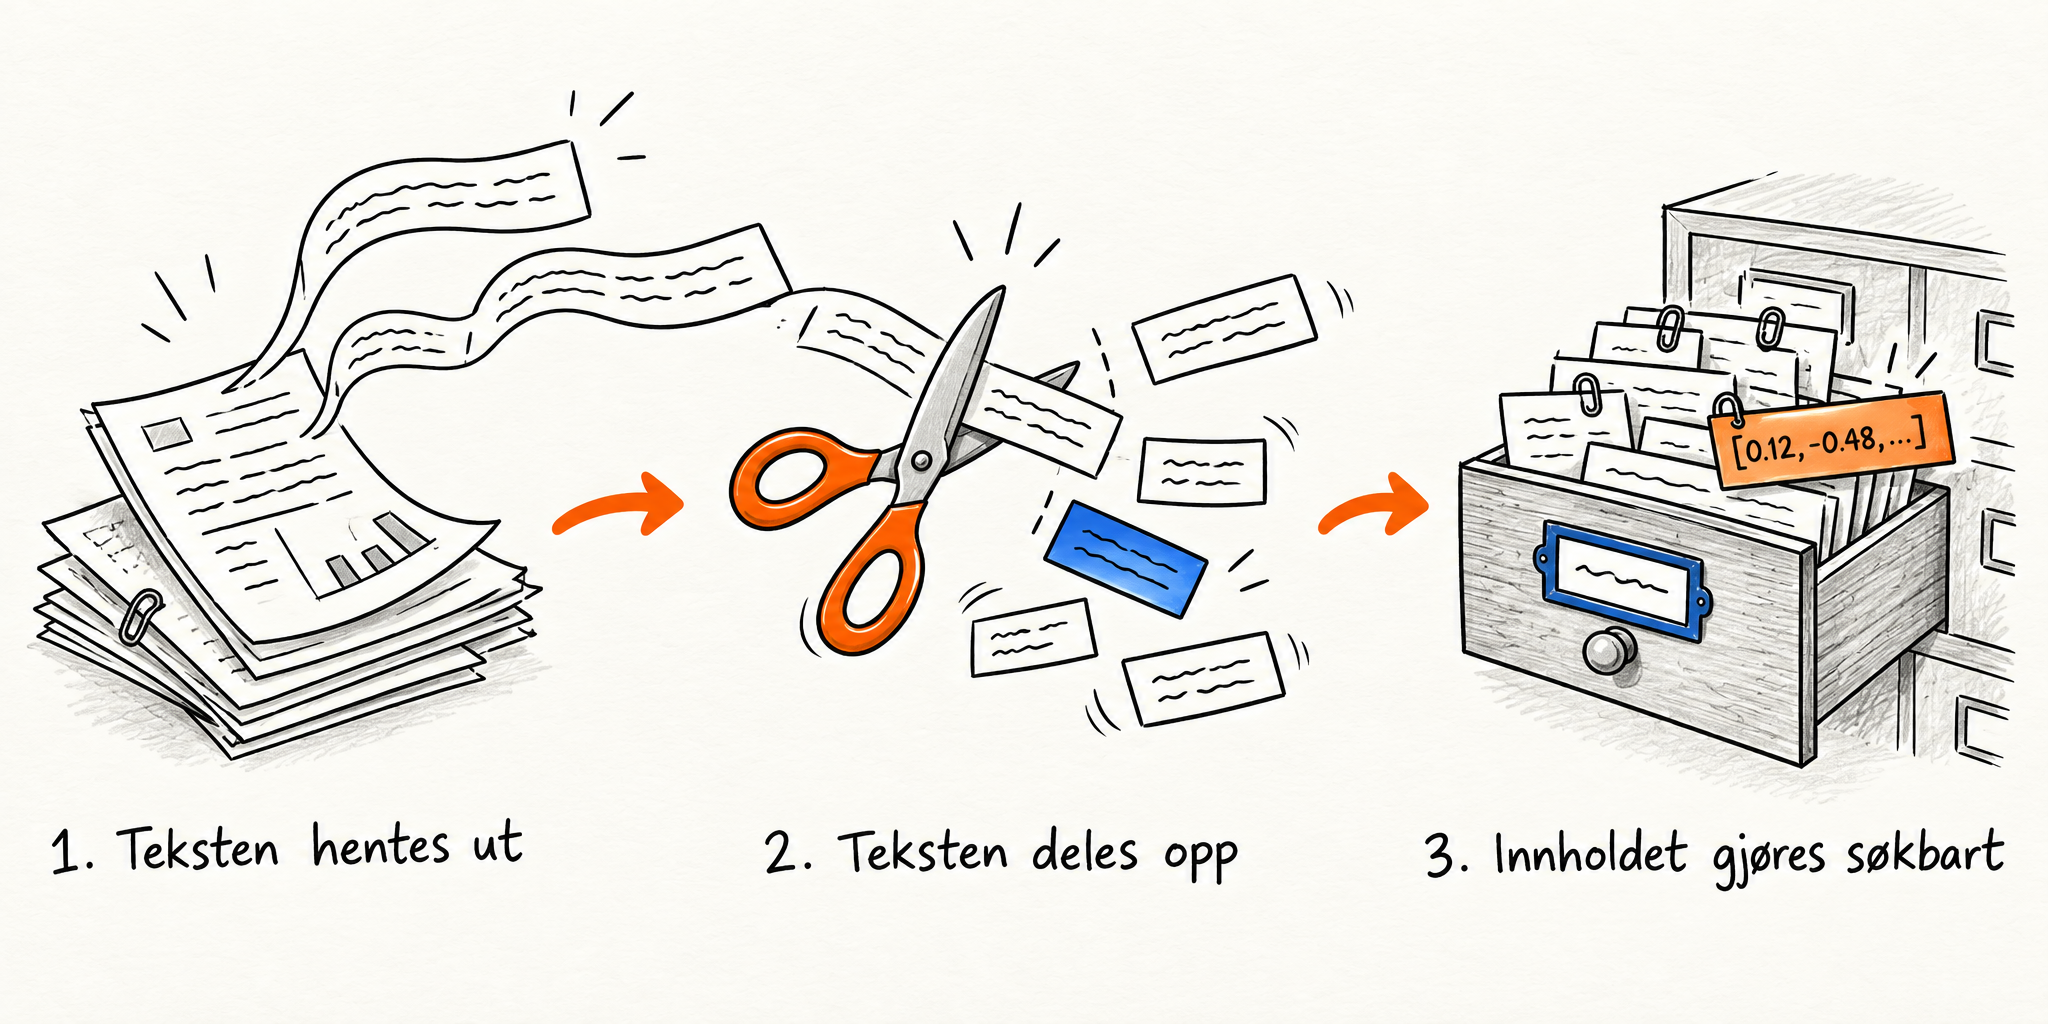
Good catch! Det kan det ikke! Når en søkeindeks bygges, må dokumentinnholdet først behandles. I mange RAG-systemer skjer dette omtrent slik:
- Teksten hentes ut. Systemet behandler innholdet i dokumentene.
- Teksten deles opp. Lengre dokumenter deles gjerne inn i mindre tekstbiter (chunks).
- Innholdet gjøres søkbart. Systemet bygger en indeks. I mange løsninger lages også matematiske representasjoner av tekstens betydning (såkalte embeddings).
Disse representasjonene gjør det mulig å søke etter informasjon basert på mening (semantisk søk), ikke bare bestemte ord.
Dette arbeidet gjøres vanligvis på forhånd, ikke hver gang noen stiller et spørsmål.
Indeksen oppdateres etter hvert som dokumenter legges til, endres eller fjernes.
Poenget er uansett det samme: Dokumentene blir normalt ikke lest fra start til slutt av AI-agenten hver gang noen stiller et spørsmål.
Gjenfinning: du stiller et spørsmål, agenten leter etter relevant informasjon
Så hva skjer når du spør: «Kan jeg jobbe fra utlandet i to uker?» Agenten leter ikke direkte i dokumentene. Den søker i indeksen som ble laget på forhånd, og henter ut tekstbitene som passer best til spørsmålet. Tekstbitene kommer fra de originale dokumentene, så svaret bygger fortsatt på det som står i kildene.
Moderne AI-agenter bruker som regel semantisk søk. Det betyr at søkesystemet søker etter informasjon med lignende betydning, ikke bare identiske ord. I praksis betyr det at selv om dokumentet heter «Retningslinjer for fjernarbeid», kan systemet finne det når du spør om å jobbe fra utlandet.
Mange moderne søkesystemer kombinerer flere teknikker, og det er ikke uvanlig med hybridsøk, som bruker for eksempel både søkeord og semantisk søk samtidig.
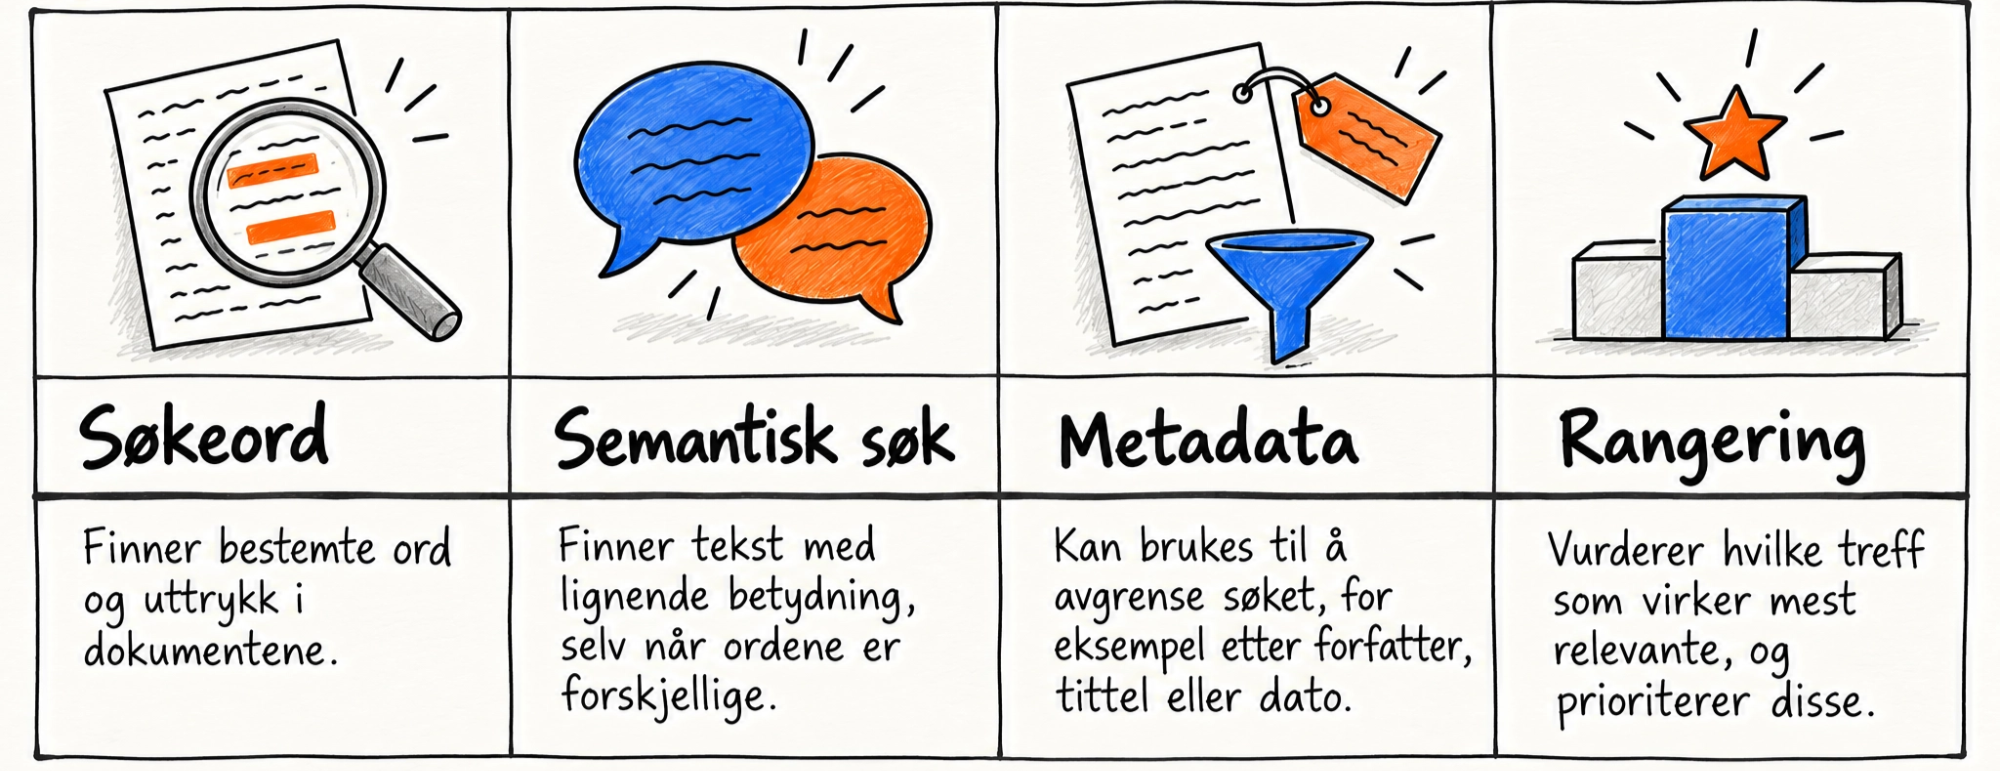
Nøyaktig hvilke teknikker som brukes og nøyaktig hvordan, varierer mellom løsningene.
Når søket er gjennomført, velger søkesystemet ut relevant innhold. Det kan være avsnitt fra flere forskjellige dokumenter. Denne informasjonen sendes videre til agenten, som bruker den til å formulere et svar, gjerne med lenker til kildene.
Obs! Det kan oppstå feil i begge ledd:
- Søkesystemet kan finne feil informasjon eller overse noe viktig.
- Agenten kan på sin side misforstå eller feiltolke informasjonen den har lest.
Derfor bør du ikke bare teste om agenten gir velformulerte svar, basert på relevante kilder, men også kvalitetssikre svaret mot originalformuleringen i kildene.
Hva betyr dette for hvordan du bør skrive og strukturere innhold i dokumenter?
Når vi forstår hvordan RAG fungerer, blir det også lettere å forstå hvorfor god utforming av interne dokumenter er så viktig for god indeksering og gjenfinning.
Det viktigste å huske er at en tekstbit (chunk) ofte blir funnet og lest alene, uten resten av dokumentet. Det har konkrete følger for hvordan man bør skrive interne rutiner og retningslinjer.
7 grep som kan gjøre informasjonen lettere å finne og bruke for AI:
1. Bruk tydelige og beskrivende overskrifter
«Retningslinjer for arbeid fra utlandet» forteller mer enn «Diverse HR». Bruk gjerne mellomtitler som beskriver hva de enkelte delene handler om. Det gjør dokumentet lettere å forstå og søke i, både for ansatte og for systemer som behandler innholdet i mindre deler.
2. Bruk riktig formatering av overskrifter
Bruk overskriftsstilene i Word, SharePoint eller Google Docs, ikke bare fet skrift. Tydelige overskrifter hjelper agenten med å finne riktig del av dokumentet, og reduserer risikoen for at agenten henter informasjon fra feil del av dokumentet.
3. Skriv slik at avsnittene gir mening på egen hånd
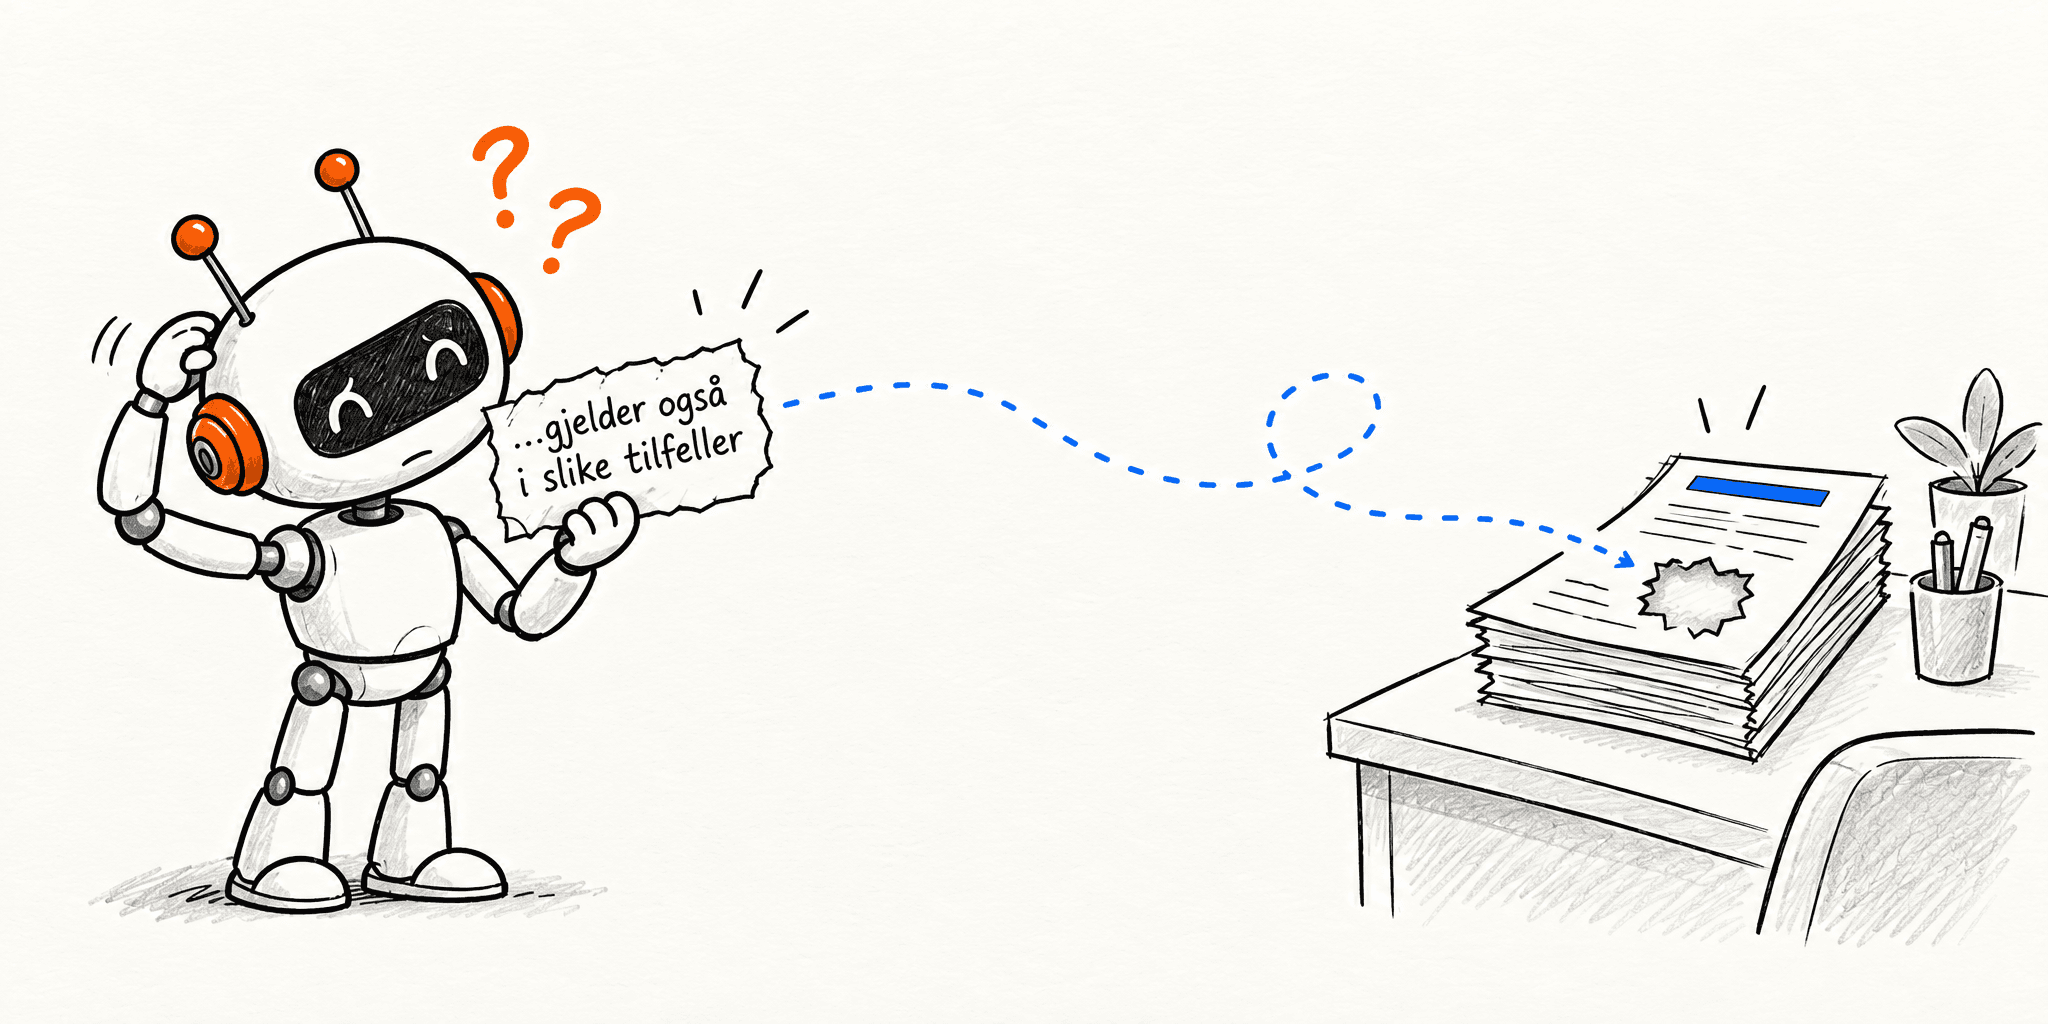
Husk at systemet kan hente ut bare deler av et dokument. Et avsnitt som begynner med «Dette gjelder også i slike tilfeller», kan bli vanskelig å tolke hvis den nødvendige konteksten ligger et annet sted i dokumentet. Skriv heller eksplisitt hva regelen gjelder.
4. Samle informasjon som hører sammen
Hvis en regel, unntakene fra regelen og godkjenningsprosessen ligger spredt på forskjellige steder, øker risikoen for at agenten ikke får med seg hele bildet. Prøv å holde nært beslektet informasjon samlet og tydelig organisert.
5. Men unngå alt-i-ett dokumenter
Samle per tema, ikke alt på ett sted. Et dokument på flere titalls sider om mange ulike temaer er vanskeligere for AI å søke presist i enn tre dokumenter med ett tydelig avgrenset tema hver.
6. Viktig informasjon bør stå som tekst.
Tekst i bilder, flytdiagrammer, skjermbilder og skannede PDF-er blir ikke alltid fanget opp av systemet. Står noe viktig i et bilde, skriv det også ut som vanlig tekst.
7. Bruk forståelige og konsekvente begreper
Hvis en prosess omtales som «fjernarbeid», «hjemmekontor», «remote work» og «fleksibelt arbeidssted» om hverandre, kan det skape unødvendig forvirring. Semantisk søk hjelper mye, men konsekvent begrepsbruk gjør fortsatt informasjonen lettere å finne og reduserer risikoen for misforståelser.
Dette er for øvrig gode prinsipper for dokumentasjon uansett om informasjonen skal leses av AI eller mennesker.
Hva kan du påvirke når du bygger en agent selv?
Hvis du bygger en agent i eksempelvis Copilot Studio, kan du påvirke mer enn bare hvilke dokumenter den får tilgang til. Men du har vanligvis lite kontroll over hvordan selve indekseringen eller søket fungerer.
Dette kan du vanligvis påvirke:
- Kunnskapskildene: Hvilke dokumenter, mapper og andre informasjonskilder agenten skal bruke.
- Avgrensning: Om agenten skal søke i et stort dokumentområde (for eksempel et SharePoint område) eller et mindre, mer relevant utvalg (utvalgte filer eller mapper).
- Instruksjoner: Hvordan agenten skal svare, håndtere usikkerhet og forholde seg til kunnskapskildene.
- Kildebeskrivelser: I løsninger som Copilot Studio kan gode beskrivelser hjelpe agenten med å velge riktig kunnskapskilde.
- Bruk av nettsøk og generell kunnskap: I mange plattformer kan du slå av bruk av generell AI-kunnskap eller nettsøk for å gjøre det vanskeligere for agenten å hallusinere og øke sannsynligheten for at svarene er utelukkende basert på utvalgte interne kunnskapskilder.
Dette har du vanligvis lite eller ingen kontroll over i standardløsninger:
- Hvordan dokumentene deles opp i tekstbiter (chunks)
- Hvordan søket rangerer alle treffene
- Nøyaktig hvilke tekstutdrag som sendes videre til agenten.
Hvor mye du kan styre dette, avhenger av hvilken plattform og type agent du bruker. Bygger du en mer skreddersydd RAG-løsning, kan du ofte kontrollere langt mer.
Til slutt: En god agent begynner med gode kunnskapskilder
RAG gjør det mulig for AI-chatboter å finne og bruke informasjon fra store dokumentsamlinger uten å lese alt på nytt hver gang.
Men selv den beste AI-agenten rydder ikke opp i rotete dokumenter, utdaterte rutiner, informasjonshull og motstridende retningslinjer.
Derfor er kvaliteten på kildene avgjørende for god gjenfinning og pålitelige AI svar. For at agenten skal finne riktig informasjon og gi korrekte svar, må datagrunnlaget være oppdatert, tydelig skrevet og godt organisert.
 ChatGPT Chat